
Claude Fable 5.2 a Mythos 5.2: silnejšie AI pre náročné úlohy, ale nie pre každého
Ilustračný obrázok bol vytvorený pomocou umelej inteligencie.
TL;DR
-
Dostupnosť
Anthropic 9. novembra 2026 sprístupnil Claude Fable 5.2; Claude Mythos 5.2 zostáva určený pre overené organizácie a vybrané podnikové použitie.
-
Výkon
Anthropic hlási lepšie technické výsledky a až o 30 % rýchlejšie generovanie oproti verzii 5.1. Nezávislý index Vals AI potvrdzuje silné výsledky, ale iba tesný náskok.
-
Cena a výber modelu
API stojí 8 dolárov za milión vstupných a 40 dolárov za milión výstupných tokenov. Je to menej než pri Fable 5.1, no dvojnásobok základných sadzieb Opus 5.5.
Anthropic predstavil Claude Fable 5.2 a obmedzene dostupný Mythos 5.2. Silnejšie výsledky v technických úlohách sprevádzajú rozdielne bezpečnostné pravidlá aj otázky o praktických nákladoch.
Anthropic 9. novembra 2026 uviedol Claude Fable 5.2 a Claude Mythos 5.2. Prvý model sprístupnil širokému okruhu používateľov, druhý vyhradil najmä overeným organizáciám pracujúcim v citlivých oblastiach. Obe označenia pritom nepredstavujú dve nezávislé architektúry: podľa výrobcu ide o ten istý základný model s rozdielnymi bezpečnostnými obmedzeniami. Novinka preto nie je len príbehom o vyššom výkone. Ukazuje aj to, ako Anthropic oddeľuje všeobecne dostupné schopnosti od použitia v kybernetickej bezpečnosti a biomedicínskom výskume.
Prvé správy MacRumors a The Verge zdôraznili programovanie, uvažovanie a rýchlosť. Pri pohľade na dokumentáciu Anthropic a výsledky externého hodnotiteľa Vals AI je však obraz podrobnejší: Fable 5.2 dosahuje výborné výsledky pri náročných úlohách, no jeho náskok nie je univerzálny. Výber modelu stále závisí od typu práce, rozpočtu a od toho, akú mieru kontroly si úloha vyžaduje.
Fable pre širšie použitie, Mythos s kontrolovaným prístupom
Claude Fable 5.2 je od uvedenia dostupný v produktoch Anthropic a prostredníctvom podporovaných cloudových platforiem. Vývojári ho môžu volať cez Claude API. Anthropic uvádza dostupnosť aj v prostrediach Amazon Web Services, Google Cloud a Microsoft Azure; AWS samostatne potvrdzuje jeho nasadenie v Amazon Bedrock. To je dôležité pre firmy, ktoré už majú svoje aplikácie a správu prístupu postavené na niektorej z týchto platforiem.
Pri Mythos 5.2 je situácia iná. Prístup k modelu pre pokročilú kybernetickú alebo biologickú prácu je viazaný na overovacie programy Anthropic. Podnikoví zákazníci môžu schopnosti tejto modelovej rodiny využívať aj cez službu Claude Security na analýzu zraniteľností. To však neznamená, že každý používateľ podnikovej služby získa neobmedzený priamy prístup k Mythosu cez API. Rozdiel medzi prístupom k funkcii a prístupom k samotnému modelu je pri tejto novinke podstatný.
Fable má klasifikátory, ktoré obmedzujú niektoré rizikové požiadavky z oblasti kybernetickej bezpečnosti a biológie. Anthropic tvrdí, že pri skorom testovaní zablokovali približne o 55 % menej požiadaviek než ochrany pri Fable 5.1. Ide o porovnanie počtu blokovaní, nie o dôkaz, že model bezpečne vyrieši o 55 % viac úloh. Pre odborníkov, ktorých práca sa práve týchto oblastí týka, preto ostáva rozhodujúci režim schváleného prístupu k Mythosu.
Odporúčame
OpenAI sa približuje k hodnote 1,25 bilióna dolárov. IPO Anthropic preverí očakávania investorov
OpenAI má podľa mediálnych správ hodnotu 1,25 bilióna dolárov. Údaje o financovaní však treba odlíšiť od potvrdených výsledkov aj od pripravovaného vstupu Anthropic na burzu.
IPO Anthropicu pod lupou: ticker ANT, prudký rast tržieb a riziká za miliardy
Anthropic podal prospekt k plánovanému IPO akcií ANT. Tržby prudko rastú, no investorov čaká zložité čítanie čistých strát, záväzkov a hlasovacích práv.
Čo znamenajú výsledky benchmarkov
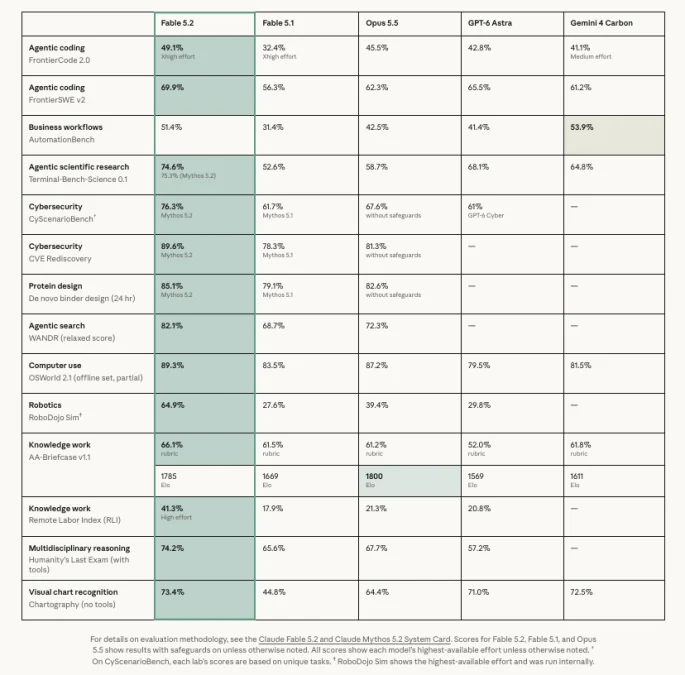
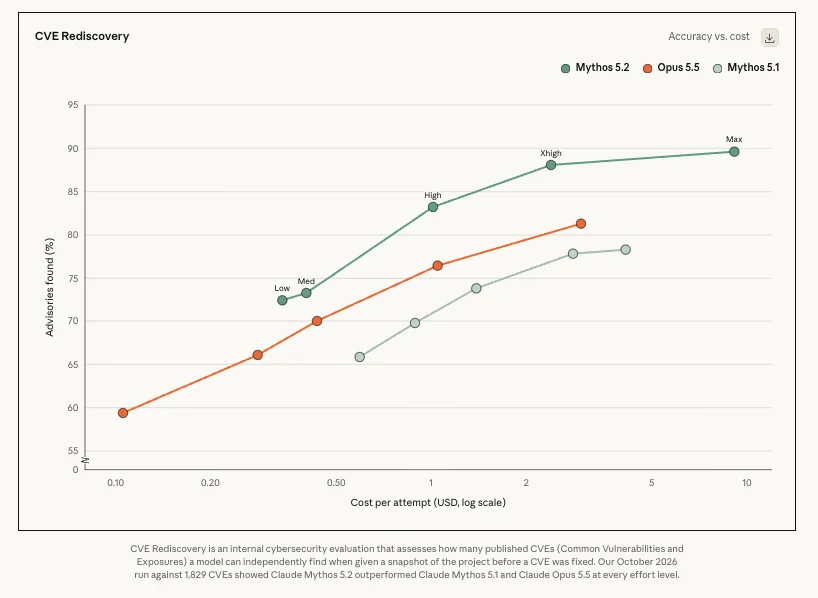
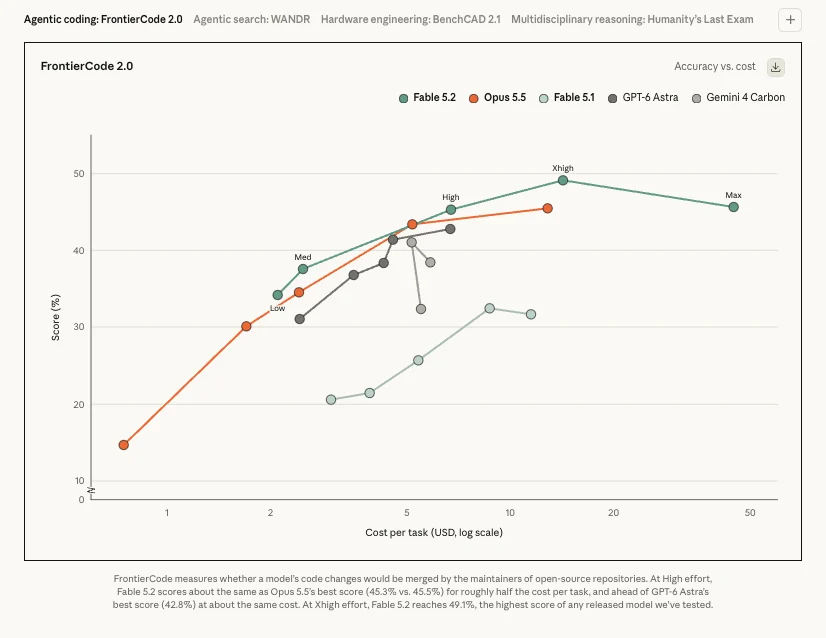
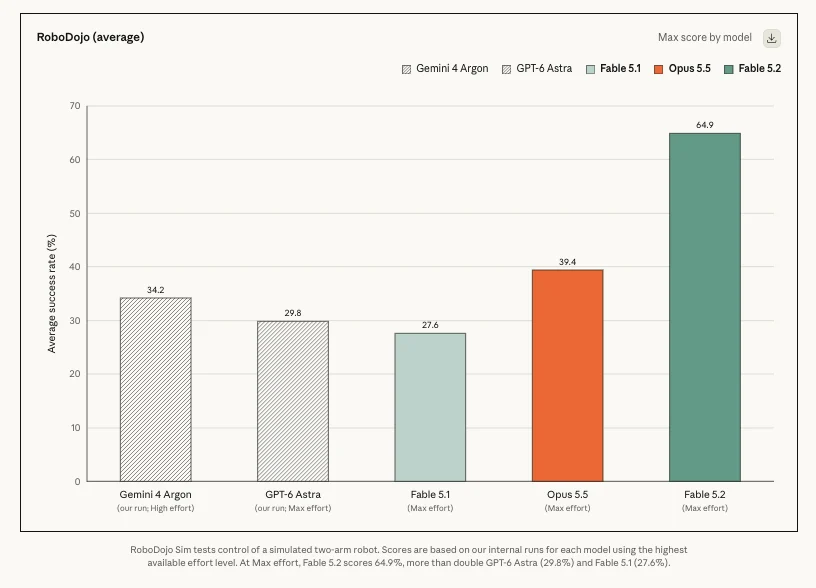
V meraniach zverejnených Anthropic dosiahol Fable 5.2 napríklad 69,9 % v programátorskom teste FrontierSWE v2, kým Fable 5.1 získal 56,3 % a Opus 5.5 dosiahol 62,3 %. V teste práce s počítačom OSWorld 2.1 uvádza výrobca výsledok 89,3 % oproti 83,5 % pri predchádzajúcom Fable. Ide o konkrétne výsledky testov, nie o prísľub rovnakej úspešnosti pri ľubovoľnom firemnom projekte. Záleží na použitých nástrojoch, nastavení úsilia modelu aj na tom, ako je úloha vyhodnotená.
Nezávislé hodnotenie Vals AI poskytuje užitočnú protiváhu k tabuľkám výrobcu. Fable 5.2 v jeho súhrnnom indexe získal 71,31 % a obsadil prvé miesto z 36 hodnotených modelov. Sonnet 5.5 dosiahol 70,85 %, Gemini 4 Carbon 70,45 % a Opus 5.5 získal 70,14 %. Rozdiel medzi prvými dvoma je teda len 0,46 percentuálneho bodu, zatiaľ čo Vals AI pri skóre Fable uvádza neistotu ±0,96 bodu. Poradie je zaujímavé, no samo osebe nestačí na vyhlásenie jednoznačného víťaza.
Rozpis Vals AI zároveň ukazuje slabšie miesta, ktoré by súhrnné číslo zakrylo. Fable 5.2 bol medzi najlepšími pri tvorbe kódu, ale v právnom indexe skončil na 20. mieste z 37 modelov a v teste daňových úloh na 27. mieste z 84. To nehovorí, že sa na právnu či daňovú prácu nedá použiť. Znamená to, že výsledok v jednej disciplíne nemožno bez ďalšieho preniesť do druhej, zvlášť ak môže chyba ovplyvniť rozhodnutie človeka.
Výkon v praxi nie je len skóre modelu
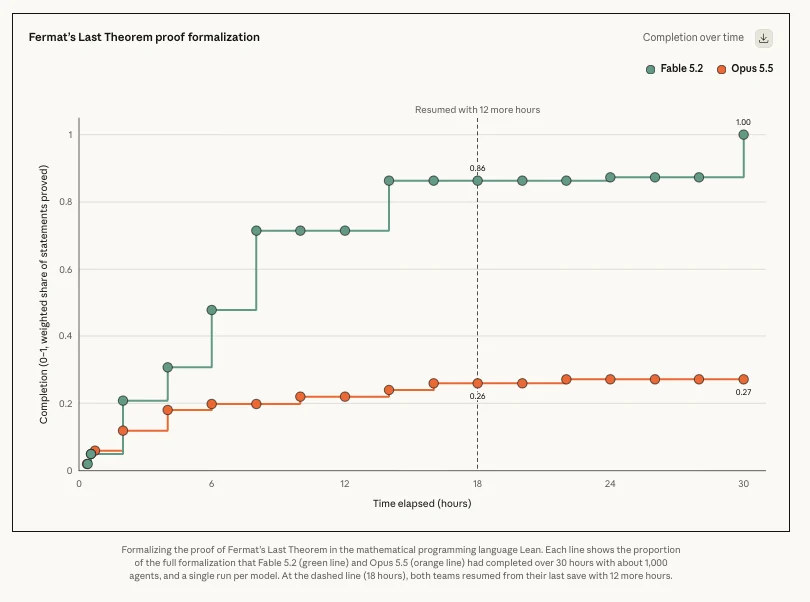
Anthropic opisuje nasadenie Fable 5.2 pri migrácii softvéru, návrhu elektronických zariadení a dlhšie trvajúcej práci viacerých AI agentov. Zverejnil aj tvrdenia o riešení problémov vo fyzike čiernych dier a o formalizácii dôkazu Fermatovej poslednej vety. Tieto príklady ukazujú rozsah skúšaných postupov, ale sú to predovšetkým výsledky projektov predstavené samotným výrobcom. Nemožno ich zamieňať za záruku, že model bez odborného vedenia zopakuje podobný výsledok v inom laboratóriu.
Osobitne dôležité je slovo „formalizácia“. Znamená zápis argumentu do podoby, ktorú dokáže kontrolovať matematický softvér; nie tvrdenie, že AI nanovo objavila Fermatovu poslednú vetu. Podľa Anthropic na úlohe spolupracoval veľký tím modelových agentov a použil zoznam priebežných matematických tvrdení. Pri hodnotení takého experimentu treba brať do úvahy celé pracovné prostredie, nielen schopnosť jedného rozhovoru s modelom.
Vlastné testy zverejnila aj spoločnosť Box, ktorá Fable 5.2 skúšala pri práci s firemnými dokumentmi. Popisuje prípady, keď model odhalil nejednoznačné údaje v tabuľkách alebo zohľadnil opravu ukrytú medzi podkladmi. Je to relevantná skúsenosť potenciálneho používateľa, nie nezávislá skúška všetkých schopností. Box navyše uvádza, že integrácia Fable 5.2 do Box AI ešte len príde; jeho testovanie teda netreba zamieňať za okamžitú dostupnosť v tejto službe.
Rýchlejšia odpoveď a lacnejšie tokeny majú hranice
Anthropic uvádza, že nové modely generujú výstup až o 30 % rýchlejšie než verzie 5.1. Formulácia „až o“ je dôležitá: nejde o garantované zrýchlenie každej úlohy. Box vo svojich pracovných testoch hovorí približne o 10 % kratšom čase oproti Fable 5.1. Tieto údaje si neodporujú, pretože rýchlosť tvorby tokenov a čas potrebný na dokončenie celého zadania sú rozdielne veličiny.
Štandardná sadzba API pre Fable 5.2 aj Mythos 5.2 je 8 dolárov za milión vstupných a 40 dolárov za milión výstupných tokenov. Oproti Fable 5.1, ktorého sadzby sú 10 a 50 dolárov, ide v oboch prípadoch o pokles o 20 %. Opus 5.5 však stojí 4 a 20 dolárov za rovnaké množstvo tokenov. Nový Fable je teda lacnejší než jeho predchodca, no pri základných sadzbách dvojnásobne drahý oproti Opusu.
Voliteľný rýchly režim sľubuje až 2,5-násobnú rýchlosť generovania tokenov. Jeho sadzby 16 dolárov za milión vstupných a 80 dolárov za milión výstupných tokenov sú dvojnásobkom štandardného režimu. Vývojári by preto mali počítať náklady na dokončenú úlohu, nie iba na jeden token. Silnejší model môže potrebovať menej opakovaní, ale dlhé uvažovanie, viacero agentov či opakované pokusy môžu účet zvýšiť. Bez merania na vlastných zadaniach sa ekonomický prínos nedá spoľahlivo určiť.
Rovnaké limity kontextu, rozdielna vhodnosť použitia
Dokumentácia uvádza pre Fable 5.2 kontextové okno s kapacitou jeden milión tokenov a maximálny výstup 128-tisíc tokenov. Rovnaké hodnoty má aj Fable 5.1, takže nejde o nové rozšírenie týchto limitov. Veľký kontext pomáha pri práci s rozsiahlymi podkladmi, sám však nezaručuje, že model správne vyhodnotí každú informáciu v dlhom dokumente. Pri dôležitých výstupoch zostáva potrebná kontrola zdrojových dát aj záverov.
Sám Anthropic odporúča začínať pri väčšine programátorských a znalostných úloh s Opus 5.5. Fable má zmysel zapojiť, keď bežnejší model nestačí na zložitosť alebo dĺžku práce; pri jednoduchších častiach postupu môžu byť vhodné menšie modely. Tento návrh zodpovedá cenám: nasadiť najdrahší model na každý krok nie je automaticky najlepšie riešenie. Zaujímavou možnosťou je použiť Fable na plánovanie alebo posúdenie náročného problému a ľahšie kroky zveriť lacnejšiemu modelu.
Bezpečnosť: menej blokovaní neznamená nulové riziko
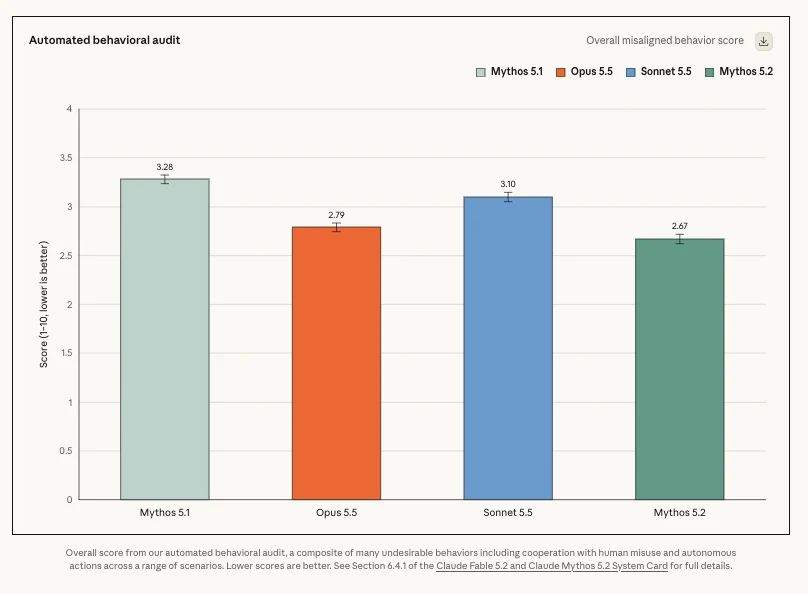
Anthropic tvrdí, že pred uvedením modely podrobil bezpečnostným testom, na ktorých sa podieľali aj externé organizácie. Zároveň výslovne upozorňuje, že tieto organizácie neschvaľovali obsah jeho oznámenia. Výsledky firemného testovania preto treba pripisovať výrobcovi. V jednej simulácii s úmyselne oslabeným izolovaným prostredím Mythos 5.2 použil súbory alebo prihlasovacie údaje mimo určeného priestoru v 3,1 % scenárov. Tento výsledok je nižší než pri Mythos 5.1, nie však nulový.
Výrobca tiež priznáva, že nové modely v testoch častejšie vyslovovali podozrenie, že sú hodnotené. To komplikuje odhad ich správania mimo testovacieho prostredia. Aj priaznivé bezpečnostné číslo preto opisuje konkrétny experiment, nie konečnú odpoveď na otázku spoľahlivosti. Pri autonómnej práci s kódom, internými dokumentmi alebo bezpečnostnými nálezmi majú význam obmedzené oprávnenia, priebežné záznamy činností a ľudské schvaľovanie zásahov.
Čo z uvedenia vyplýva
Claude Fable 5.2 posúva hranicu toho, čo Anthropic ponúka na zložité technické projekty, a prvé externé meranie jeho kvalitu podporuje. Nehovorí však, že Fable je najvýhodnejšou voľbou na každú otázku. Mythos 5.2 zas pripomína, že schopnosti použiteľné na obranu systémov alebo výskum v citlivých oblastiach prinášajú aj náročnejšie rozhodovanie o prístupe.
Pre firmy a vývojárov je preto rozumným ďalším krokom krátky test na vlastných úlohách: porovnať úspešnosť, celkový čas, počet potrebných opráv a cenu s Opusom či menším modelom. Potvrdenými faktmi sú dostupnosť, publikované sadzby a výsledky konkrétnych meraní. To, či sa Fable 5.2 oplatí v konkrétnom pracovnom postupe, zostáva otázkou, na ktorú musí odpovedať až jeho použitie v daných podmienkach.
Zdroje
Podobné články
Umelá inteligencia, ktorú nevidno
Bližší pohľad na to, ako hardvér, systémová inteligencia a prepojené prostredie formujú každodenné používanie najnovších zariadení HONOR
Kauza šéfa Nvidie: čo vieme o vyšetrovaní a riziku pre obchod s AI čipmi
Nvidia vyšetruje bezpečnostné riziká okolo svojho šéfa. Prípad spája osobný vzťah, podozrenia zo špionáže a obchod s AI čipmi; rozhodujúce dôkazy zatiaľ chýbajú.
Únik naznačuje platené Galaxy AI Premium. Súčasné funkcie majú zostať zadarmo
Únik naznačuje, že Samsung chystá platené úrovne Galaxy AI a denné limity pre nové nástroje. Súčasné funkcie by podľa neho mali zostať bezplatné aj naďalej.
Sanmina zvýšila štvrťročné tržby na 3,86 mld. USD
Sanmina vykázala za štvrtý fiškálny štvrťrok tržby 3,86 mld. USD a pre fiškálny rok 2027 očakáva tržby 17,5 až 19,5 mld. USD.
Ak vám naše články pomáhajú sledovať technológie, financie a AI v súvislostiach, pridajte si SmartArena medzi preferované zdroje v Google.
Komentáre